Xây Knowledge Base chuẩn để AI trả lời khách không sai lệch
Lộ trình xây Knowledge Base chuẩn 3 tầng, phân loại dữ liệu và gắn metadata giúp doanh nghiệp SME giảm ảo giác AI, trả lời khách hàng nhất quán và chính xác.
Điểm nổi bật
7 mục
Điểm nổi bật
7 mục Chương trình dành cho doanh nghiệpKhông cần biết lập trìnhXây dựng đội ngũ AI Agent cho doanh nghiệpTừ lựa chọn use case đến thiết kế quy trình, quản trị rủi ro và đo hiệu quả vận hành.Khám phá chương trìnhHọc thực chiến cùng DATMarketing
Xây Knowledge Base chuẩn để AI trả lời khách không sai lệch là nền tảng giúp doanh nghiệp SME chấm dứt cảnh chatbot nói trôi chảy nhưng báo sai điều khoản đổi trả hoặc khuyến mãi đã hết hạn, gây khiếu nại và tốn nhân lực xử lý.
Sự cố này bắt nguồn từ nguyên lý "Rác vào thì rác ra" (Garbage In, Garbage Out). Bản chất của LLM (Mô hình ngôn ngữ lớn) chỉ là bộ máy suy luận ngôn ngữ, nên độ chính xác phụ thuộc hoàn toàn vào cơ sở tri thức đầu vào để giảm ảo giác AI khi chăm sóc khách hàng.
Bài viết cung cấp lộ trình thiết kế cấu trúc Knowledge Base 3 tầng, phân loại dữ liệu và gắn metadata (siêu dữ liệu) giúp doanh nghiệp kiểm soát câu trả lời AI nhất quán.
Nguyên nhân AI ảo giác và vai trò Knowledge Base
AI ảo giác xảy ra khi mô hình ngôn ngữ ưu tiên dự đoán xác suất từ ngữ thay vì kiểm chứng sự thật, nhất là lúc thiếu ngữ cảnh hoặc gặp tài liệu mâu thuẫn. Knowledge Base chuẩn đóng vai trò Single Source of Truth (nguồn chân lý duy nhất), giúp giảm ảo giác AI khi chăm sóc khách hàng và chuẩn hóa dữ liệu RAG cho doanh nghiệp.
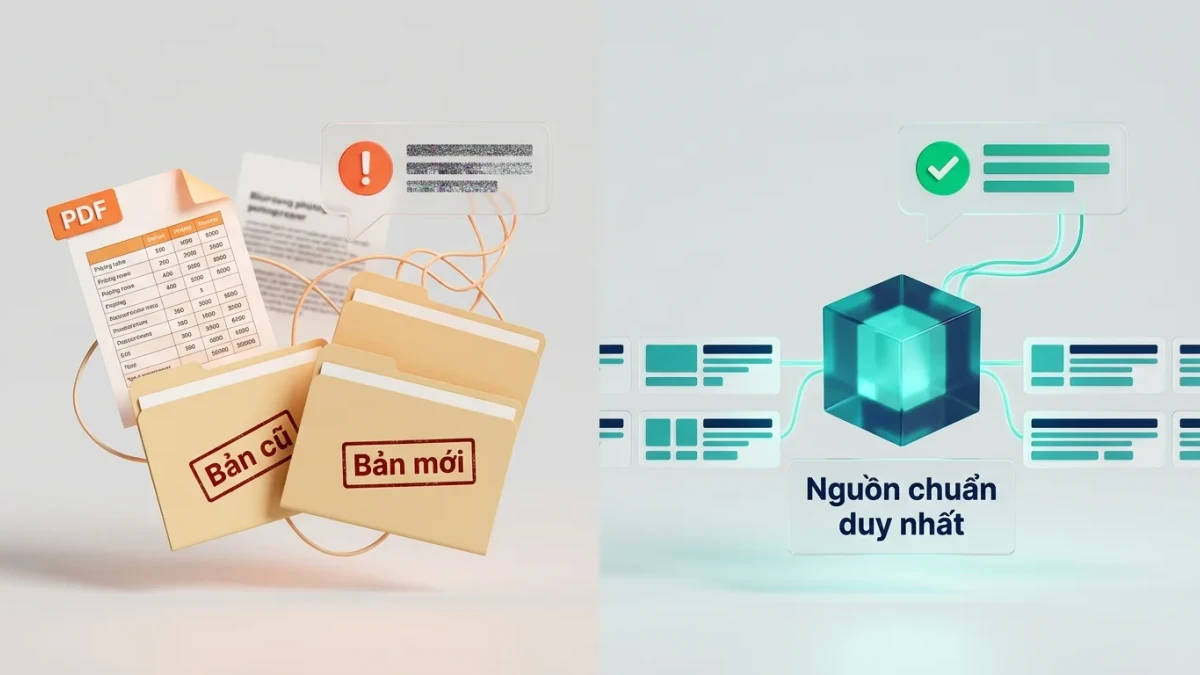
Theo tài liệu từ Anthropic Documentation, ép buộc mô hình chỉ phản hồi dựa trên ngữ cảnh truy xuất sẽ ngăn bịa đặt thông tin. Tại SME (doanh nghiệp nhỏ và vừa), sai lệch thường do 3 lỗi:
- PDF, ảnh scan vỡ cấu trúc: Hệ thống đọc sót chữ, sai lệch bảng giá.
- Chính sách chồng chéo: Phiên bản cũ và mới lẫn lộn khiến AI trích nhầm.
- Thiếu ranh giới từ chối: Chatbot tự suy diễn khi không tìm thấy dữ liệu.
| Tiêu chí | Tài liệu thô | Knowledge Base chuẩn |
|---|---|---|
| Độ chính xác truy xuất | Thấp, dễ vỡ bảng biểu | Cao, trích đúng đoạn sạch |
| Tỷ lệ sai lệch chính sách | Cao do lẫn bản cũ | Rất thấp, một nguồn chuẩn |
| Kiểm soát và cập nhật | Chậm, sửa toàn bộ tệp | Nhanh gọn theo từng mục |
Để đồng bộ kho tri thức trước khi tích hợp chatbot, đội ngũ vận hành nên tham khảo cách quản lý tài liệu thương hiệu bằng Claude Projects nhằm chuẩn hóa dữ liệu đầu vào.
Cấu trúc Knowledge Base chuẩn 3 tầng cho AI Agent
Cấu trúc Knowledge Base chuẩn 3 tầng cho AI Agent là mô hình phân tách tri thức thành 3 lớp: Tầng Dữ liệu lõi cố định, Tầng Dữ liệu vận hành động và Tầng Kịch bản xử lý tình huống. Cách tổ chức này giúp xây Knowledge Base chuẩn để AI trả lời khách không sai lệch và truy xuất đúng thông tin ưu tiên.
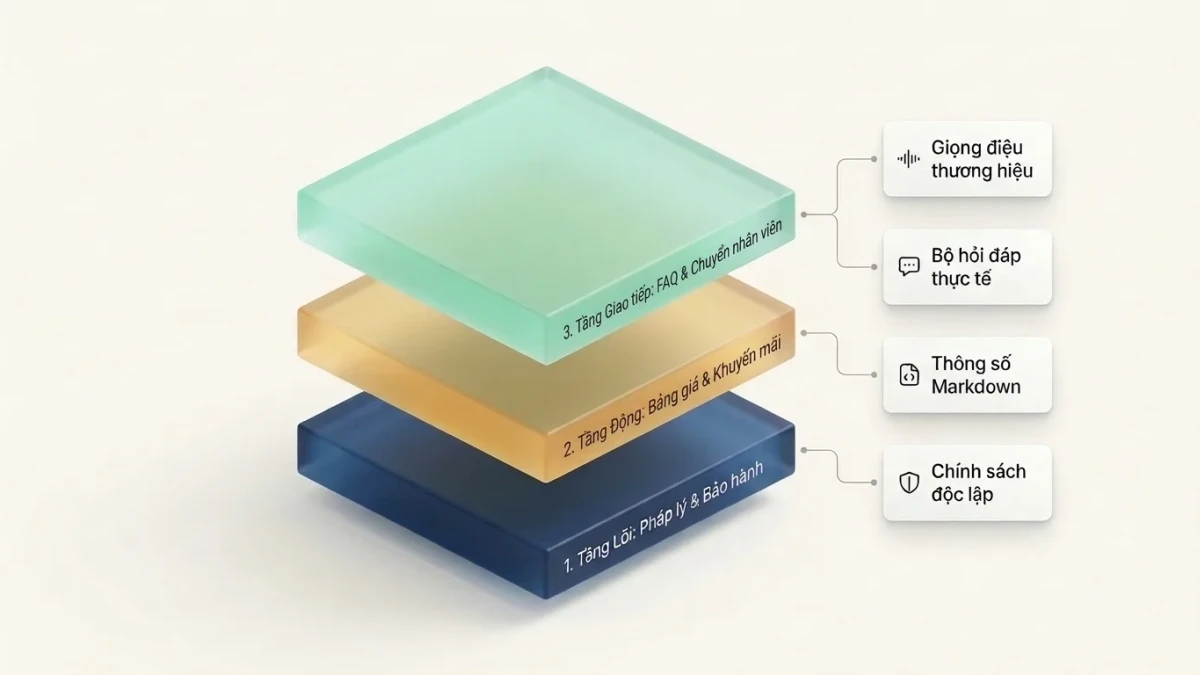
- Tầng Lõi (Core Policy & Brand): Chứa thông tin pháp lý, chính sách bảo hành và định vị thương hiệu ít thay đổi.
- Tầng Động (Dynamic Catalog): Lưu bảng giá, tồn kho và chương trình khuyến mãi cập nhật theo tuần hoặc tháng.
- Tầng Giao tiếp (Conversational FAQ & Edge Cases): Tổng hợp bộ hỏi đáp thực tế và quy tắc leo thang chuyển nhân viên.
Nhiều doanh nghiệp mắc sai lầm khi trộn file khuyến mãi theo tháng vào chung tài liệu bảo hành, khiến AI suy diễn sai thời hạn áp dụng. Phân tầng rõ ràng ngay từ đầu sẽ tạo nền tảng vững chắc để ứng dụng AI tư vấn sản phẩm chính xác theo nhu cầu khách.
Phân loại 4 nhóm dữ liệu chăm sóc khách hàng
Để xây dựng cơ sở tri thức cho chatbot AI vận hành ổn định, trưởng phòng CSKH cần tách bạch 4 nhóm dữ liệu đầu vào trước khi nạp vào hệ thống:
- Thông tin sản phẩm và thông số kỹ thuật: Chuyển bảng giá phức tạp thành văn bản cấu trúc Markdown hoặc cặp khóa - giá trị (key-value) rõ ràng.
- Chính sách bán hàng, thanh toán, vận chuyển, đổi trả: Tách từng chính sách thành một đơn vị độc lập thay vì gộp chung file dài hàng chục trang.
- Bộ câu hỏi thường gặp (FAQ) và xử lý từ chối: Chuẩn hóa câu hỏi thực tế của khách hàng theo từng tình huống mua hàng.
- Quy tắc giọng văn và giới hạn phạm vi: Quy định rõ điều kiện chuyển giao cho nhân sự thật, kết hợp phương pháp huấn luyện AI giao tiếp tự nhiên.
Đội ngũ vận hành cần áp dụng nguyên tắc "Không dùng dữ liệu ngầm": mọi quy định truyền miệng của nhân viên phải được văn bản hóa thành câu điều kiện "Nếu... thì..." tường minh để đảm bảo cách train AI trả lời khách hàng chính xác. Đồng thời, doanh nghiệp cần tuân thủ quy tắc bảo mật dữ liệu doanh nghiệp khi huấn luyện AI, tuyệt đối không nạp dữ liệu định danh cá nhân (PII) thực tế của khách hàng lên công cụ AI bên thứ ba khi chưa có sự đồng ý hợp pháp.
Thiết lập metadata giúp AI truy xuất đúng nguồn
Trong quy trình chuẩn hóa dữ liệu RAG cho doanh nghiệp, Metadata Filtering đóng vai trò bộ lọc giúp hệ thống thu hẹp phạm vi tìm kiếm trước khi tổng hợp câu trả lời. Theo tài liệu về kiến trúc Retrieval-Augmented Generation (RAG) của Google Cloud, cơ chế truy xuất có điều kiện giúp ngăn tình trạng trộn lẫn thông tin giữa các dòng sản phẩm khi hoàn thiện cấu trúc Knowledge Base chuẩn cho AI Agent.
| Trường Metadata | Ý nghĩa | Ví dụ giá trị |
|---|---|---|
category | Nhóm chủ đề tài liệu | chinh_sach_doi_tra |
product_line | Dòng sản phẩm áp dụng | may_loc_nuoc_ro |
effective_date | Ngày bắt đầu hiệu lực | 2026-11-01 |
status | Trạng thái sử dụng | active / archived |
audience | Phân khúc khách hàng | khach_le / dai_ly |
Về quy tắc kiểm soát phiên bản, khi cập nhật bảng giá mới, bộ phận vận hành bắt buộc chuyển trạng thái tài liệu cũ sang archived thay vì chỉ tải thêm file mới lên kho tri thức.
Quy trình 5 bước chuẩn hóa dữ liệu RAG cho doanh nghiệp
Để chuẩn hóa dữ liệu RAG cho doanh nghiệp (tạo sinh tăng cường truy xuất), đơn vị cần thực hiện 5 bước: gom nguồn tài liệu tập trung, thanh lọc dữ liệu nhiễu, chuyển đổi định dạng có cấu trúc, gắn siêu dữ liệu và kiểm thử truy xuất trong môi trường cô lập.
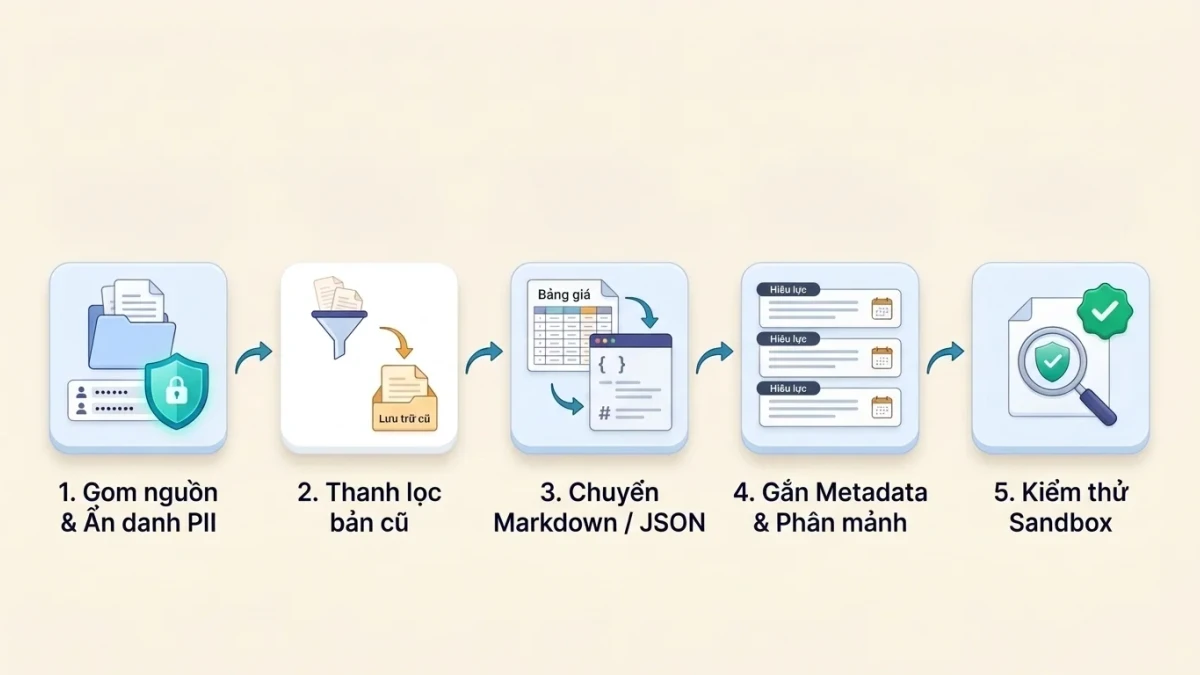
- Bước 1 - Kiểm kê và gom nguồn dữ liệu: Tập hợp tài liệu phân tán từ PDF, Google Docs, hệ thống quản lý quan hệ khách hàng (CRM) và lịch sử chăm sóc khách hàng về kho lưu trữ phân quyền rõ ràng. Tuyệt đối không đưa dữ liệu định danh cá nhân (PII) lên công cụ AI bên thứ ba khi chưa được phép.
- Bước 2 - Thanh lọc tài liệu nhiễu: Loại bỏ văn bản trùng lặp, khuyến mãi hết hạn hoặc bảng giá sai lệch trước khi nạp vào vector database (cơ sở dữ liệu vector).
- Bước 3 - Chuẩn hóa định dạng: Chuyển bảng giá dạng ảnh, tệp quét sang Markdown hoặc JSON nhằm tạo cấu trúc Knowledge Base chuẩn cho AI Agent.
- Bước 4 - Gắn thẻ và phân mảnh: Bổ sung metadata (phòng ban, ngày hiệu lực, nhóm sản phẩm) và chia nhỏ nội dung theo ngữ cảnh.
- Bước 5 - Kiểm thử truy xuất: Nạp dữ liệu vào môi trường sandbox (thử nghiệm cô lập) để đo lường độ chính xác trước khi vận hành.
Theo tài liệu Retrieval-Augmented Generation (RAG) Use Cases & Architecture của Google Cloud, kết nối mô hình ngôn ngữ lớn với kho tri thức nội bộ có kiểm soát giúp câu trả lời bám sát dữ liệu thực tế và hạn chế sai lệch.
Làm sạch và loại bỏ tài liệu nội bộ lỗi thời
Khi xây dựng cơ sở tri thức cho chatbot AI, nguyên nhân phổ biến nhất khiến AI báo sai giá là tồn tại nhiều phiên bản tài liệu song song. Trưởng phòng vận hành và CSKH cần áp dụng nguyên tắc Single Source of Truth: mỗi chính sách bảo hành, đổi trả hoặc bảng giá chỉ giữ duy nhất một bản có hiệu lực và gắn nhãn ngày cập nhật.
| Nhóm tài liệu xung đột | Rủi ro khi nạp vào RAG | Cách xử lý dứt điểm |
|---|---|---|
| File báo giá cũ trên Drive | AI trích xuất giá khuyến mãi đã hết hạn | Chuyển bản cũ vào thư mục Archive tách biệt |
| Tin nhắn chốt đơn Zalo của sale | Thông tin ưu đãi riêng bị hiểu thành quy định chung | Chỉ trích lọc quy chuẩn đã duyệt vào kho chính |
| FAQ website chưa cập nhật | Mâu thuẫn thời gian giao hàng với quy trình mới | Rà soát đồng bộ trước khi kết nối nguồn dữ liệu |
Doanh nghiệp nên đặt tên tệp theo quy ước thống nhất kèm ngày hiệu lực (ví dụ: Chinh_sach_bao_hanh_2026_11.md) và khóa quyền đồng bộ đối với thư mục lưu trữ cũ.
Áp dụng kỹ thuật phân mảnh dữ liệu theo ngữ cảnh
Nhiều quản lý SME gặp tình trạng AI trả lời thiếu điều kiện đi kèm khi thực hiện chuẩn hóa dữ liệu RAG cho doanh nghiệp. Lỗi này xuất phát từ việc cắt văn bản máy móc theo số ký tự cố định, vô tình tách rời tiêu đề chính sách khỏi phần ngoại lệ bên dưới. Chẳng hạn, đoạn quy định chiết khấu 15% bị tách khỏi điều kiện áp dụng cho đơn hàng từ 50 sản phẩm trở lên sẽ khiến chatbot báo giá sai cho khách lẻ.
Để khắc phục, đội ngũ kỹ thuật nên áp dụng kỹ thuật phân mảnh theo cấu trúc đề mục (Semantic/Markdown Chunking), kết hợp độ gối đầu (overlap) hợp lý nhằm giữ trọn mạch ý giữa hai đoạn liền kề. Bên cạnh đó, hãy chèn thêm tiêu đề ngữ cảnh (context header) vào đầu mỗi mảnh dữ liệu, chẳng hạn ghi rõ [Sản phẩm A - Chính sách bảo hành - Khách hàng B2B], giúp AI nhận diện chính xác đối tượng áp dụng ngay khi truy xuất.
Chuẩn hóa văn phong để train AI trả lời đúng
Cách train AI trả lời khách hàng chính xác phụ thuộc lớn vào độ tường minh của câu chữ trong tài liệu gốc. Các câu văn dài dòng hoặc chứa đại từ mơ hồ như "sản phẩm này", "chính sách trên" dễ bị mất nghĩa khi tách thành từng mảnh vector độc lập. Đội ngũ Marketing và CSKH cần viết lại câu với chủ ngữ cụ thể, nêu rõ điều kiện và ngoại lệ ngay trong cùng một câu.
- Trước biên tập: "Sản phẩm này được đổi trả miễn phí trong 7 ngày theo chính sách trên, trừ các trường hợp đặc biệt."
- Sau biên tập: "Máy lọc không khí Model X được đổi trả miễn phí trong 7 ngày kể từ ngày nhận hàng nếu còn nguyên tem bảo hành, không áp dụng cho lỗi va đập vật lý."
Cấu trúc Hỏi - Đáp ngắn gọn, tách bạch giá bán, thời gian giao hàng và điều kiện bảo hành giúp mô hình trích xuất thông tin nhất quán hơn. Khi kết hợp kho tri thức này với quy trình hướng dẫn tối ưu kịch bản chăm sóc khách hàng tự động trong hệ thống quản trị nội bộ, đội ngũ CSKH sẽ giảm đáng kể thời gian xử lý phản hồi thủ công.
5 nguyên tắc giảm ảo giác AI khi chăm sóc khách hàng
Để giảm ảo giác AI khi chăm sóc khách hàng, doanh nghiệp cần thiết lập bộ rào chắn kỹ thuật khóa chặt phản hồi theo dữ liệu thật. Kết hợp chỉ dẫn hệ thống nghiêm ngặt, tinh chỉnh tham số mô hình, lọc ngưỡng tương đồng và trích dẫn nguồn đối chiếu sẽ triệt tiêu tình trạng bịa đặt thông tin.
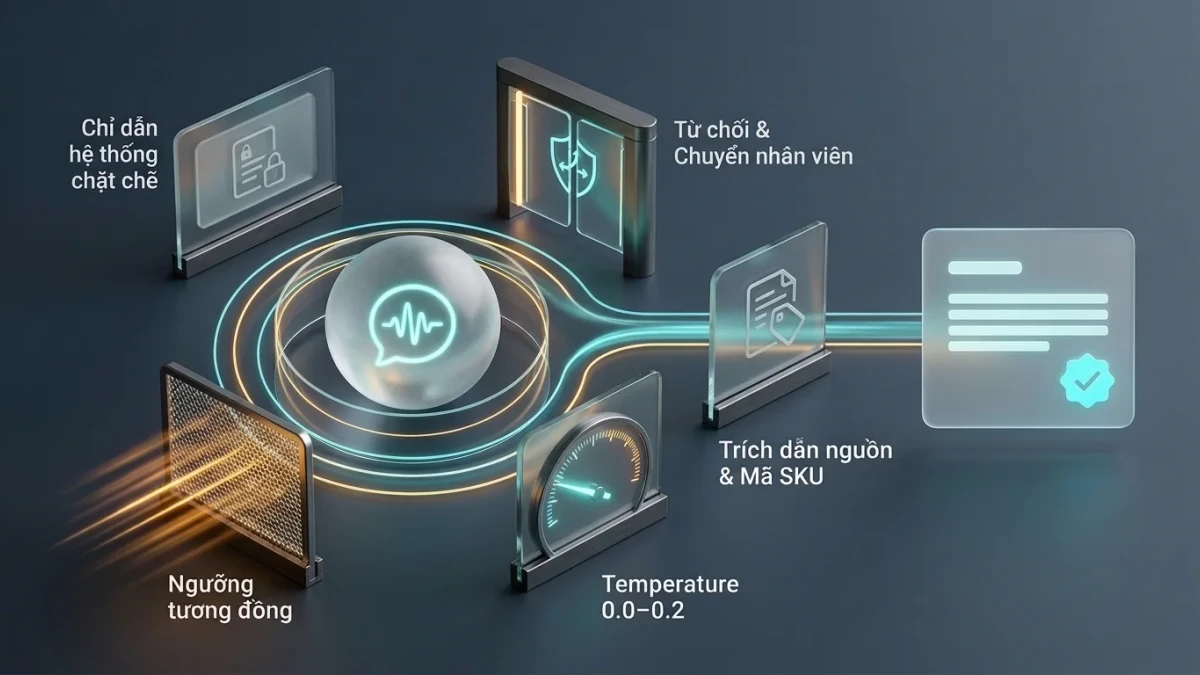
- Nguyên tắc 1 & 2 (Ràng buộc System Prompt): Cấu hình System Prompt (chỉ dẫn hệ thống) ép AI chỉ trả lời dựa trên tài liệu truy xuất được, đồng thời bắt buộc từ chối lịch sự hoặc chuyển ngay cho nhân viên khi thiếu dữ liệu.
- Nguyên tắc 3 & 4 (Kiểm soát tham số sinh từ): Hạ thông số Temperature (mức độ sáng tạo) về 0.0–0.2 để hạn chế suy diễn tự do và thiết lập similarity threshold (ngưỡng điểm tương đồng) nhằm lọc bỏ ngữ cảnh kém liên quan trước khi sinh câu trả lời.
- Nguyên tắc 5 (Trích dẫn & kiểm duyệt tự động): Yêu cầu đính kèm nguồn tài liệu nội bộ hoặc mã SKU (mã sản phẩm), kích hoạt kiểm duyệt tự động cho câu hỏi về giá, hoàn tiền, hợp đồng và tuyệt đối không nạp dữ liệu định danh cá nhân (PII) của khách hàng lên công cụ bên thứ ba.
Áp dụng đồng bộ 5 rào chắn này giúp hoàn thiện quy trình xây Knowledge Base chuẩn để AI trả lời khách không sai lệch, giữ vững uy tín thương hiệu.
Quy trình kiểm thử và cập nhật tri thức AI định kỳ
Để duy trì độ chính xác khi xây dựng cơ sở tri thức cho chatbot AI, doanh nghiệp cần kiểm thử nhật ký hội thoại hàng tuần, rà soát toàn diện hàng tháng và đồng bộ dữ liệu ngay mỗi khi thay đổi chính sách hay khuyến mãi.
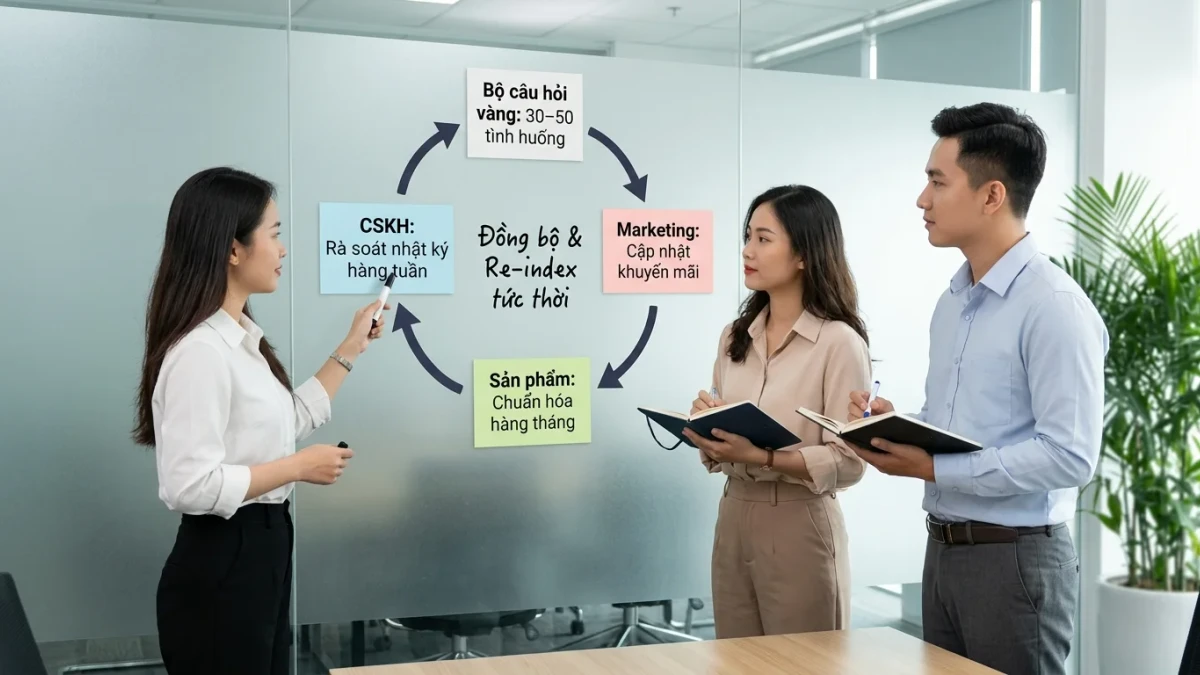
- Bước 1 - Tạo bộ câu hỏi kiểm thử vàng (Golden Dataset): Tổng hợp 30 đến 50 tình huống khách hay hỏi nhất, bao gồm cả câu hỏi bẫy hoặc yêu cầu ngoài phạm vi để đo giới hạn phản hồi.
- Bước 2 - Rà soát nhật ký thất bại hàng tuần: Đội ngũ Chăm sóc khách hàng (CSKH) lọc các phiên trả lời sai để phát hiện lỗ hổng và bổ sung ngay cặp câu hỏi - đáp án còn thiếu.
- Bước 3 - Đồng bộ và tái lập chỉ mục (re-index) tức thời: Làm mới dữ liệu ngay khi tung ưu đãi hoặc đổi chính sách, đồng thời ẩn danh dữ liệu định danh cá nhân (PII) trước khi nạp.
Kỷ luật 3 bước này là cách train AI trả lời khách hàng chính xác theo bảng phân công sau:
| Bộ phận | Chu kỳ | Nhiệm vụ trọng tâm |
|---|---|---|
| CSKH | Hàng tuần | Lọc nhật ký lỗi, bổ sung câu hỏi thực tế. |
| Marketing | Hàng tuần / Theo chiến dịch | Cập nhật thông tin khuyến mãi, mã giảm giá. |
| Sản phẩm | Hàng tháng | Chuẩn hóa thông số và chính sách vận hành. |
Câu hỏi thường gặp (FAQ)
Xây dựng cấu trúc Knowledge Base chuẩn cho AI Agent giúp doanh nghiệp vừa và nhỏ (SME) giảm tải cho đội ngũ tư vấn. Chỉ với 15–20 tài liệu cốt lõi chuẩn hóa trong 3–5 ngày, hệ thống đã sẵn sàng phản hồi khách hàng đầy đủ và chính xác.
1. Doanh nghiệp SME cần bao nhiêu tài liệu để xây Knowledge Base cho AI?
Doanh nghiệp không cần nạp toàn bộ kho lưu trữ ngay từ đầu. Hãy tập trung vào 15–25 tài liệu trọng tâm gồm bảng giá, chính sách bảo hành, quy trình đặt hàng và 20 câu hỏi phổ biến nhất để AI truy xuất nhanh, tránh trả lời lan man.
2. Nên dùng file PDF, Word hay Google Docs để nạp dữ liệu cho AI?
Ưu tiên hàng đầu là định dạng Markdown (.md), kế đến là Google Docs hoặc Word (.docx) vì chúng giữ nguyên cấu trúc tiêu đề và bảng biểu. Với tệp PDF, cần tránh bản scan dạng ảnh để AI không đọc sót hay sai lệch số liệu.
3. Bao lâu cần cập nhật lại cơ sở tri thức cho chatbot AI một lần?
Chu kỳ phù hợp là rà soát định kỳ mỗi tháng 1 lần và cập nhật tức thì khi thay đổi bảng giá hoặc chính sách bán hàng. Chỉ cần 1 nhân sự kiểm tra nhật ký hội thoại 30 phút mỗi tuần để bổ sung kịp thời các câu hỏi mới.
Tổng kết & Lời khuyên hành động
Để xây Knowledge Base chuẩn giúp AI trả lời khách không sai lệch, doanh nghiệp cần giữ vững công thức: Dữ liệu một nguồn duy nhất + Phân mảnh đúng ngữ cảnh + Kiểm thử định kỳ.
- Đồng bộ nguồn dữ liệu: Hợp nhất quy trình, bảng giá và chính sách về một kho tri thức duy nhất để AI không trích xuất thông tin lỗi thời.
- Hành động theo quy tắc 80/20: Chọn 20% nhóm câu hỏi chiếm 80% lượng tin nhắn mỗi ngày để chuẩn hóa và thử nghiệm trước khi mở rộng toàn doanh nghiệp.
- An toàn thông tin: Tuyệt đối không đưa dữ liệu định danh cá nhân (PII) thực tế của khách hàng lên công cụ AI bên thứ ba khi chưa có sự đồng ý hợp pháp.
Hãy bắt đầu rà soát lại kho tài liệu chăm sóc khách hàng hiện tại, hoặc liên hệ đội ngũ chuyên môn của chúng tôi để được tư vấn kiến trúc AI Agent phù hợp quy mô doanh nghiệp vừa và nhỏ (SME).
Bài viết liên quan
Xem tất cả Chuyển đổi số
DevOps cho đội ngũ tinh gọn: Triển khai nhanh & ổn định
DevOps cho đội ngũ tinh gọn xóa bỏ điểm nghẽn phát hành, giúp nhóm kỹ thuật dưới 15 nhân sự triển khai phần mềm nhanh và duy trì hệ thống ổn định bền vững.
 Chuyển đổi số
Bảo mật dữ liệu khách hàng theo ISO 27001:2022
Khung ISO 27001:2022 với 93 biện pháp kiểm soát giúp doanh nghiệp bảo vệ dữ liệu khách hàng, quản trị rủi ro an toàn thông tin và tuân thủ Nghị định 13.
 Chuyển đổi số
Lộ trình chuyển đổi số tinh gọn cho doanh nghiệp nhỏ
Khám phá lộ trình chuyển đổi số tinh gọn cho doanh nghiệp nhỏ qua 5 bước chọn lọc quy trình cốt lõi, giúp SME tối ưu 40% chi phí và tăng năng suất vận hành.